Владелец «Кофейной лавки» хочет получать один и тот же отчёт каждый месяц — по свежей выгрузке. Значит, анализ должен быть записан так, чтобы его можно было запустить снова, ничего не меняя, и чтобы через полгода было понятно, что делает каждая строка. Соберём такой отчёт из цепочек. Новых методов в проекте нет.
import pandas as pd

raw = pd.read_csv("data/shop_orders.csv", parse_dates=["date"])
raw.head(3)| order_id | date | customer_id | city | channel | category | product | price | quantity | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 10001 | 2025-01-01 | C095 | Москва | маркетплейс | Аксессуары | Кофемолка ручная | 3200 | 2 |
| 1 | 10001 | 2025-01-01 | C095 | Москва | маркетплейс | Чай | Травяной сбор 50 г | 260 | 1 |
| 2 | 10002 | 2025-01-01 | C059 | Москва | приложение | Сладости | Шоколад горький | 180 | 1 |
Шаг 1. Подготовка — одной функцией
Выручка строки и номер месяца нужны почти в каждом расчёте. Оформим их добавление функцией: тогда любая
цепочка начнётся одинаково — .pipe(prepare).
Допишите функцию prepare(table): она возвращает таблицу с двумя новыми столбцами — revenue (цена ×
количество) и month (номер месяца из date). Исходную таблицу функция менять не должна. Затем сохраните
в orders результат её применения к raw.
return table.assign(revenue=lambda d: d["price"] * d["quantity"], month=lambda d: d["date"].dt.month) — в одном assign можно задать несколько столбцов.orders = raw.pipe(prepare).Заготовка упражнения обновилась с тех пор, как вы сохранили свой код.
Вернуть заготовку? Ваш код в этом упражнении будет удалён.
def prepare(table):
    return ...


orders = ...Упражнение пока не решено, поэтому для ячеек ниже выполнено эталонное решение — ваш код не изменён.
def prepare(table):
    return table.assign(
        revenue=lambda d: d["price"] * d["quantity"],
        month=lambda d: d["date"].dt.month,
    )


orders = raw.pipe(prepare)
Шаг 2. Выручка по месяцам
Цепочкой от raw получите monthly — выручку по месяцам: подготовка через pipe, группировка по month,
сумма revenue. В best_month сохраните номер месяца с наибольшей выручкой.
.pipe(prepare), затем .groupby("month")["revenue"] и .sum() — каждый шаг с новой строки.Заготовка упражнения обновилась с тех пор, как вы сохранили свой код.
Вернуть заготовку? Ваш код в этом упражнении будет удалён.
monthly = (
    raw
    # допишите шаги цепочки
)
best_month = ...Упражнение пока не решено, поэтому для ячеек ниже выполнено эталонное решение — ваш код не изменён.
monthly = (
    raw
    .pipe(prepare)
    .groupby("month")["revenue"]
    .sum()
)
best_month = monthly.idxmax()
Шаг 3. Каналы и доля сайта
В цепочке можно не только сворачивать данные, но и добавлять столбцы к уже свёрнутой таблице — assign
с lambda получит сводную таблицу «на этом шаге».
Цепочкой от raw получите channels: сводная таблица выручки (месяцы в строках, каналы в столбцах), к которой
добавлены столбцы total — сумма трёх каналов — и site_share — доля сайта в total, три знака.
.pivot_table(values="revenue", index="month", columns="channel", aggfunc="sum")..assign(total=lambda d: d["сайт"] + d["приложение"] + d["маркетплейс"]), затем ещё один assign для site_share.Заготовка упражнения обновилась с тех пор, как вы сохранили свой код.
Вернуть заготовку? Ваш код в этом упражнении будет удалён.
channels = (
    raw
    # допишите шаги цепочки
)Упражнение пока не решено, поэтому для ячеек ниже выполнено эталонное решение — ваш код не изменён.
channels = (
    raw
    .pipe(prepare)
    .pivot_table(values="revenue", index="month", columns="channel", aggfunc="sum")
    .assign(total=lambda d: d["сайт"] + d["приложение"] + d["маркетплейс"])
    .assign(site_share=lambda d: (d["сайт"] / d["total"]).round(3))
)channels.head(4)| channel | маркетплейс | приложение | сайт | total | site_share |
|---|---|---|---|---|---|
| month | |||||
| 1 | 81700 | 106380 | 130860 | 318940 | 0.410 |
| 2 | 66650 | 50450 | 133330 | 250430 | 0.532 |
| 3 | 86720 | 96070 | 114990 | 297780 | 0.386 |
| 4 | 115660 | 66120 | 157510 | 339290 | 0.464 |
Здесь два assign подряд — так нагляднее, что site_share считается из уже готового total. Можно и одним:
столбцы в assign создаются по порядку, и lambda следующего видит предыдущие.
Шаг 4. Свой шаг с параметрами
«Лучшие товары категории» пригодятся для любой категории и любого числа товаров — значит, это функция с параметрами. Внутри неё — тоже цепочка.
Допишите функцию top_products(table, category, n): она возвращает таблицу из n товаров категории
category с наибольшей выручкой — столбцы product и revenue, индекс с нуля. Затем получите top_tea —
два лучших чая — цепочкой с двумя pipe.
query параметр функции — как любая переменная: .query("category == @category")..groupby("product", as_index=False)["revenue"], .sum(), .nlargest(n, "revenue"), .reset_index(drop=True).raw.pipe(prepare).pipe(top_products, "Чай", 2).Заготовка упражнения обновилась с тех пор, как вы сохранили свой код.
Вернуть заготовку? Ваш код в этом упражнении будет удалён.
def top_products(table, category, n):
    return (
        table
        # допишите шаги: отбор категории, сумма revenue по товарам, n лучших, индекс с нуля
    )


top_tea = ...Упражнение пока не решено, поэтому для ячеек ниже выполнено эталонное решение — ваш код не изменён.
def top_products(table, category, n):
    return (
        table
        .query("category == @category")
        .groupby("product", as_index=False)["revenue"]
        .sum()
        .nlargest(n, "revenue")
        .reset_index(drop=True)
    )


top_tea = raw.pipe(prepare).pipe(top_products, "Чай", 2)
Шаг 5. График
Метод plot — такой же шаг, как остальные; им цепочка может заканчиваться.
Цепочкой от raw постройте линейный график выручки трёх каналов по месяцам и сохраните в ax: подготовка,
сводная таблица месяцы × каналы, plot с заголовком «Выручка по каналам, 2025». Подпишите оси: X — «месяц»,
Y — «₽».
.plot(title="Выручка по каналам, 2025").ax.set_xlabel("месяц") и ax.set_ylabel("₽").Заготовка упражнения обновилась с тех пор, как вы сохранили свой код.
Вернуть заготовку? Ваш код в этом упражнении будет удалён.
ax = (
    raw
    # допишите шаги цепочки; последний — .plot(...)
)
# подпишите осиУпражнение пока не решено, поэтому для ячеек ниже выполнено эталонное решение — ваш код не изменён.
ax = (
    raw
    .pipe(prepare)
    .pivot_table(values="revenue", index="month", columns="channel", aggfunc="sum")
    .plot(title="Выручка по каналам, 2025")
)
ax.set_xlabel("месяц")
ax.set_ylabel("₽")
Доля сайта — уже посчитанный столбец; для двенадцати значений подойдут столбцы:
channels["site_share"].plot(kind="bar", title="Доля сайта в выручке по месяцам", rot=0)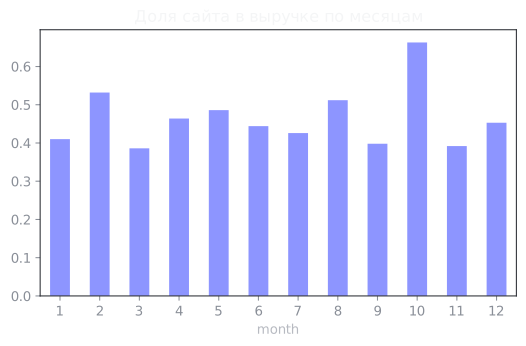
Весь путь целиком
Вот как выглядит отчёт «от файла до графика» одной цепочкой. Здесь собрано многое из курса: чтение с датами, свой шаг, фильтр, индекс из дат, пересчёт в недели, окно и график.
(
    pd.read_csv("data/shop_orders.csv", parse_dates=["date"])
    .pipe(prepare)
    .query("category == 'Кофе'")
    .set_index("date")["revenue"]
    .resample("W")
    .sum()
    .iloc[1:-1]
    .rolling(4)
    .mean()
    .plot(title="Кофе: выручка за неделю, среднее за 4 недели")
)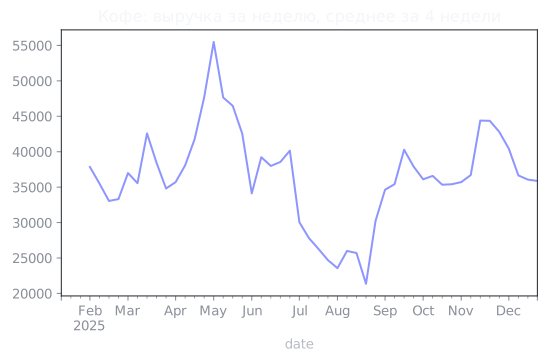
Прочитайте её сверху вниз: загрузить → подготовить → оставить кофе → даты в индекс → сложить по неделям → убрать неполные недели → сгладить окном в четыре недели → нарисовать. Каждая строка — один шаг, и каждый можно закомментировать, чтобы посмотреть на промежуточный результат.
Выводы
- Сайт даёт от 39 до 66 % выручки в зависимости от месяца; самая высокая его доля — в октябре.
- Лучшие чаи — улун и зелёный; по кофе лидирует «Эфиопия 250 г», за ней — килограммовая «Бразилия», а «Эспрессо-смесь» и «Колумбия 250 г» идут почти вровень.
- У кофе есть весенний подъём в апреле и провал в июле — августе. На сглаженном графике пик виден на пару
недель позже: скользящее среднее ставит значение в конец окна (урок о
rolling).
И главное — про сам код. Функцию prepare мы написали один раз и использовали на каждом шаге. Если владелец попросит
считать выручку со скидкой, правка понадобится в одном месте. Это и есть «хороший код» для аналитика:
не самый короткий и не самый хитрый, а такой, который легко прочитать, проверить и запустить снова.