Двенадцать чисел месячной выручки можно прочитать глазами. Триста шестьдесят пять дневных — уже нет.
График показывает то, что в таблице не разглядеть: рост и спад, всплески, необычные значения. В pandas
график строится одним методом — plot. Рисует его библиотека matplotlib; pandas лишь передаёт ей данные.
import pandas as pd

orders = pd.read_csv("data/shop_orders.csv", parse_dates=["date"])
orders["revenue"] = orders["price"] * orders["quantity"]
orders["month"] = orders["date"].dt.month
monthly = orders.groupby("month")["revenue"].sum()
monthly.head(3)month 1 318940 2 250430 3 297780 Name: revenue, dtype: int64
Линия
monthly.plot()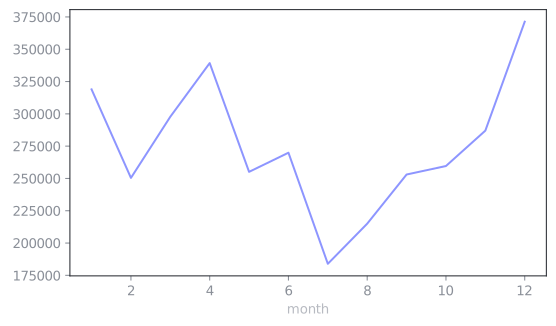
По горизонтали — индекс, по вертикали — значения; подпись горизонтальной оси — название индекса (month). Линия — вид графика по умолчанию; она подходит, когда
точки идут по порядку и между соседними есть смысл проводить отрезок: время, возраст, расстояние.
График без подписей — полуфабрикат. Заголовок задаёт параметр title. Метод plot возвращает объект
осей (axes) — сам график; его сохраняют в переменную и подписывают оси методами set_xlabel
и set_ylabel:
ax = monthly.plot(title="Выручка по месяцам, 2025")
ax.set_xlabel("месяц")
ax.set_ylabel("₽")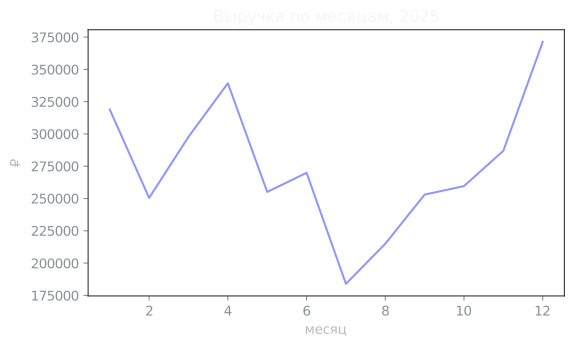
В items — число проданных штук по месяцам. Постройте линейный график с заголовком «Продано штук по месяцам»
и сохраните его в ax. Подпишите ось Y словом «штук».
ax = items.plot(title="Продано штук по месяцам").ax.set_ylabel("штук").Заготовка упражнения обновилась с тех пор, как вы сохранили свой код.
Вернуть заготовку? Ваш код в этом упражнении будет удалён.
items = orders.groupby("month")["quantity"].sum()
ax = ...Упражнение пока не решено, поэтому для ячеек ниже выполнено эталонное решение — ваш код не изменён.
items = orders.groupby("month")["quantity"].sum()
ax = items.plot(title="Продано штук по месяцам")
ax.set_ylabel("штук")
Столбцы
Если на оси не время, а категории, линия вводит в заблуждение:
by_category = orders.groupby("category")["revenue"].sum()
by_category.plot(title="Линия для категорий — плохая идея")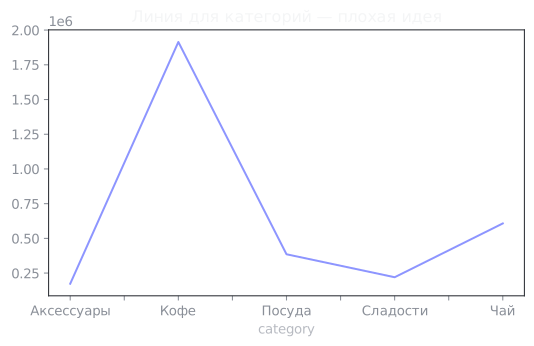
Наклон линии между «Аксессуарами» и «Кофе» ничего не значит: у категорий нет порядка и нет ничего «между».
Для сравнения категорий нужны столбцы — kind="bar":
by_category.sort_values(ascending=False).plot(kind="bar", title="Выручка по категориям", rot=0)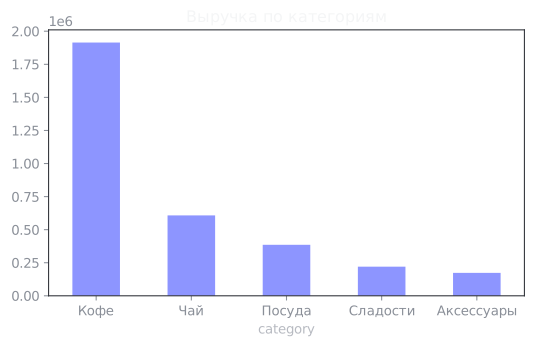
Два приёма делают её читаемой. Сортировка перед построением — глаз сразу видит порядок. И rot=0 — подписи
горизонтально (по умолчанию они повёрнуты набок).
Когда категорий много или названия длинные, столбцы кладут горизонтально — kind="barh":
by_product = orders.groupby("product")["revenue"].sum().sort_values()
by_product.tail(8).plot(kind="barh", title="Восемь товаров с наибольшей выручкой")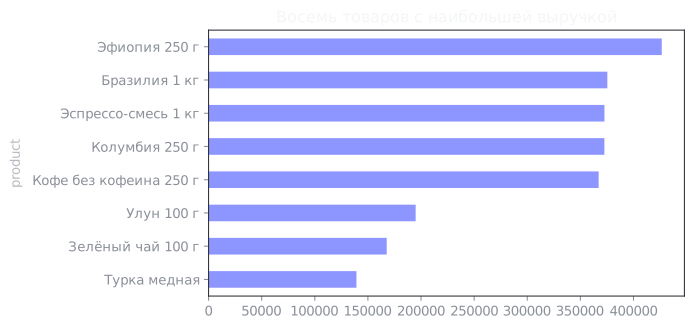
Здесь сортировка по возрастанию: на горизонтальной диаграмме первая строка рисуется внизу, и самый большой столбец оказывается сверху.
Сохраните в by_city выручку по городам по убыванию. Постройте столбчатую диаграмму с заголовком «Выручка
по городам» и сохраните в ax.
orders.groupby("city")["revenue"].sum().sort_values(ascending=False).by_city.plot(kind="bar", title="Выручка по городам", rot=0).Заготовка упражнения обновилась с тех пор, как вы сохранили свой код.
Вернуть заготовку? Ваш код в этом упражнении будет удалён.
by_city = ...
ax = ...Упражнение пока не решено, поэтому для ячеек ниже выполнено эталонное решение — ваш код не изменён.
by_city = orders.groupby("city")["revenue"].sum().sort_values(ascending=False)
ax = by_city.plot(kind="bar", title="Выручка по городам", rot=0)
Гистограмма
Третий частый вопрос — как значения распределены: каких много, каких мало. Гистограмма делит диапазон
значений на интервалы равной ширины и показывает, сколько значений попало в каждый. Это графический
pd.cut с value_counts.
orders["revenue"].plot(kind="hist", bins=30, title="Выручка одной строки заказа")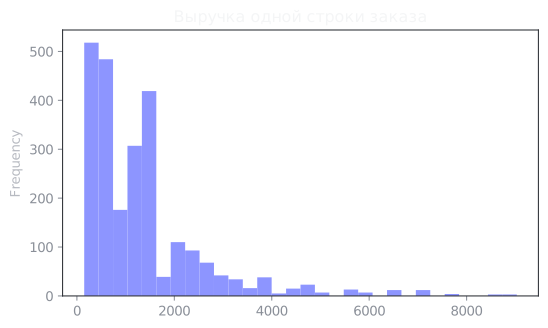
По вертикали matplotlib пишет Frequency — «частота», число значений в интервале. Сразу видно то, о чём
говорили среднее и медиана: большинство строк — до 2000 ₽, а вправо тянется длинный
«хвост» редких крупных покупок. Параметр bins задаёт число интервалов; по умолчанию их десять.
Гистограмма pd.Series([1, 2, 2, 3, 3, 3]).plot(kind="hist", bins=3) состоит из трёх столбцов. Какой высоты
самый высокий?
Сохраните в moscow_temp столбец temp_max для Москвы. Постройте гистограмму из 20 интервалов с заголовком
«Дневной максимум в Москве» и сохраните в ax. Подпишите ось X: «°C».
weather.loc[weather["city"] == "Москва", "temp_max"].moscow_temp.plot(kind="hist", bins=20, title="..."), затем ax.set_xlabel("°C").Заготовка упражнения обновилась с тех пор, как вы сохранили свой код.
Вернуть заготовку? Ваш код в этом упражнении будет удалён.
weather = pd.read_csv("data/weather.csv", parse_dates=["date"])
moscow_temp = ...
ax = ...Упражнение пока не решено, поэтому для ячеек ниже выполнено эталонное решение — ваш код не изменён.
weather = pd.read_csv("data/weather.csv", parse_dates=["date"])
moscow_temp = weather.loc[weather["city"] == "Москва", "temp_max"]
ax = moscow_temp.plot(kind="hist", bins=20, title="Дневной максимум в Москве")
ax.set_xlabel("°C")
У гистограммы два «горба» — чуть ниже нуля и около двадцати градусов: зима и лето. Среднее (9 градусов) попадает в провал между ними: дней с такой температурой в два-три раза меньше, чем на вершинах. Одно число этого не покажет.
Несколько рядов
У таблицы plot рисует по линии на каждый столбец и сам добавляет легенду:
by_channel = orders.pivot_table(values="revenue", index="month", columns="channel", aggfunc="sum")
by_channel.head(3)| channel | маркетплейс | приложение | сайт |
|---|---|---|---|
| month | |||
| 1 | 81700 | 106380 | 130860 |
| 2 | 66650 | 50450 | 133330 |
| 3 | 86720 | 96070 | 114990 |
by_channel.plot(title="Выручка по каналам")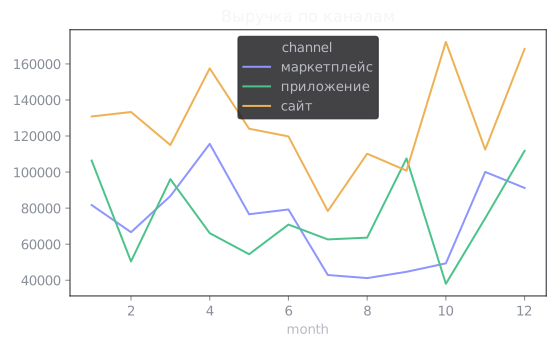
Поэтому перед графиком данные часто приводят к широкой форме: то, что должно стать отдельными линиями, — в столбцы.
Добавить линию на уже готовый график позволяет параметр ax: ему передают оси, на которых нужно рисовать.
Параметр alpha делает линию полупрозрачной:
daily = orders.groupby("date")["revenue"].sum().reindex(pd.date_range("2025-01-01", "2025-12-31"), fill_value=0)
ax = daily.plot(title="Выручка по дням и среднее за 7 дней", alpha=0.35)
daily.rolling(7).mean().plot(ax=ax)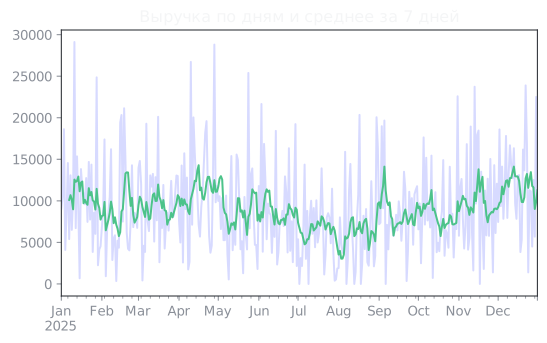
Бледная линия — шумные дневные значения, яркая — среднее за неделю. Раз в индексе настоящие даты,
matplotlib сам подписал ось месяцами — по-английски (Jan, Feb…). На ней видны весенний подъём,
летний спад и декабрьский пик.
Первая строка заготовки добавляет в weather столбец month. Соберите month_temp — сводную таблицу среднего temp_max:
месяцы в строках, города в столбцах. Постройте график для столбцов «Сочи», «Москва»,
«Новосибирск» (в этом порядке) с заголовком «Средний дневной максимум по месяцам», сохраните в ax
и подпишите ось Y: «°C».
weather.pivot_table(values="temp_max", index="month", columns="city", aggfunc="mean").month_temp[["Сочи", "Москва", "Новосибирск"]].plot(title="...").Заготовка упражнения обновилась с тех пор, как вы сохранили свой код.
Вернуть заготовку? Ваш код в этом упражнении будет удалён.
weather["month"] = weather["date"].dt.month
month_temp = ...
ax = ...Упражнение пока не решено, поэтому для ячеек ниже выполнено эталонное решение — ваш код не изменён.
weather["month"] = weather["date"].dt.month
month_temp = weather.pivot_table(values="temp_max", index="month", columns="city", aggfunc="mean")
ax = month_temp[["Сочи", "Москва", "Новосибирск"]].plot(title="Средний дневной максимум по месяцам")
ax.set_ylabel("°C")
Какой график выбрать
| Вопрос | График | kind |
|---|---|---|
| Как менялось во времени? | линия | "line" (по умолчанию) |
| Что больше, что меньше? | столбцы | "bar", "barh" |
| Как распределены значения? | гистограмма | "hist" |
Итоги
ряд.plot()— линия;kind="bar"— столбцы,kind="hist"— гистограмма.- По горизонтали — индекс: сделайте индексом то, что должно быть на оси.
title=,ax.set_xlabel(...),ax.set_ylabel(...)— подписи; без них график непонятен.- У таблицы каждый столбец — отдельная линия.
- Линия — для времени, столбцы — для категорий, гистограмма — для распределения.